Monitoring en alerting in mijn homelab: zien wat stuk is voor iemand het merkt
Gepubliceerd op 23 september 2026
7 min leestijd
1305 woorden
In de eerste post van deze reeks ging het over de vorm van mijn homelab. In de tweede over secrets en deployflow. Maar zelfs met een nette repo en een voorspelbare uitrol blijft er nog een praktische vraag over: hoe merk je snel dat er iets stuk is, traag wordt of gewoon afwijkt van wat je verwacht?
Dat is voor mij het stuk waar monitoring en alerting hun waarde bewijzen. Niet als verzameling mooie grafieken, maar als operationeel hulpmiddel. Ik wil snel kunnen zien of het systeem gezond is, waar het probleem zit en of ik meteen moet ingrijpen.
Niet alles hoeft op dezelfde plaats te draaien
De opzet van mijn monitoring volgt dezelfde logica als de rest van mijn homelab: splits verantwoordelijkheden op een manier die leesbaar blijft.
Ik heb daarom twee lagen:
- één kleine
monitoring-agentop elke host - één centrale monitoringstack op
home
Die eerste laag doet alleen het saaie maar noodzakelijke werk: metrics verzamelen en logs doorsturen. De tweede laag bewaart, visualiseert en alerteert.
Dat is ook een logisch vervolg op de vorige twee posts. Eerst wil je weten hoe je systeem bedoeld is. Daarna hoe secrets en deployflow werken. Pas dan komt de vraag hoe je merkt dat het systeem nog gezond draait eens alles live staat.
Dat ziet er in de praktijk ongeveer zo uit:
infra   -> monitoring-agent -> Prometheus / Loki / Grafana / Alertmanager
home    -> monitoring-agent -> Prometheus / Loki / Grafana / Alertmanager
media   -> monitoring-agent -> Prometheus / Loki / Grafana / Alertmanager
games   -> monitoring-agent -> Prometheus / Loki / Grafana / Alertmanager
Ik vind die scheiding belangrijk omdat de taken ook echt anders zijn. Dicht bij de workloads wil ik iets klein en voorspelbaar. Op de centrale plek wil ik net query’s, dashboards, probe-resultaten en meldingen samenbrengen.
De agentlaag moet klein en saai blijven
Per host draait die agentlaag met drie bekende bouwstenen:
cadvisorvoor containermetricsnode-exportervoor hostmetricspromtailvoor logs richting Loki
Heel kort gezegd:
cadvisorkijkt naar wat containers doennode-exporterkijkt naar de host zelf, zoals CPU, geheugen en diskpromtailverzamelt logs en stuurt ze door naar Loki, de logopslag van deze setup
Het voordeel daarvan is niet dat het exotisch is. Integendeel. Het is net nuttig omdat het saai is. Als een host half stuk gaat, wil ik niet dat daar ook nog eens allerlei complexe dashboard- of alertlogica op staat. Die host moet gewoon blijven vertellen wat hij nog kan vertellen.
Die keuze helpt ook bij herstel. Als ik een host opnieuw moet opbouwen, hoef ik de monitoringlaag daar niet opnieuw uit te vinden. Die blijft klein, herkenbaar en bijna overal gelijk.
Grafana beantwoordt voor mij twee verschillende vragen
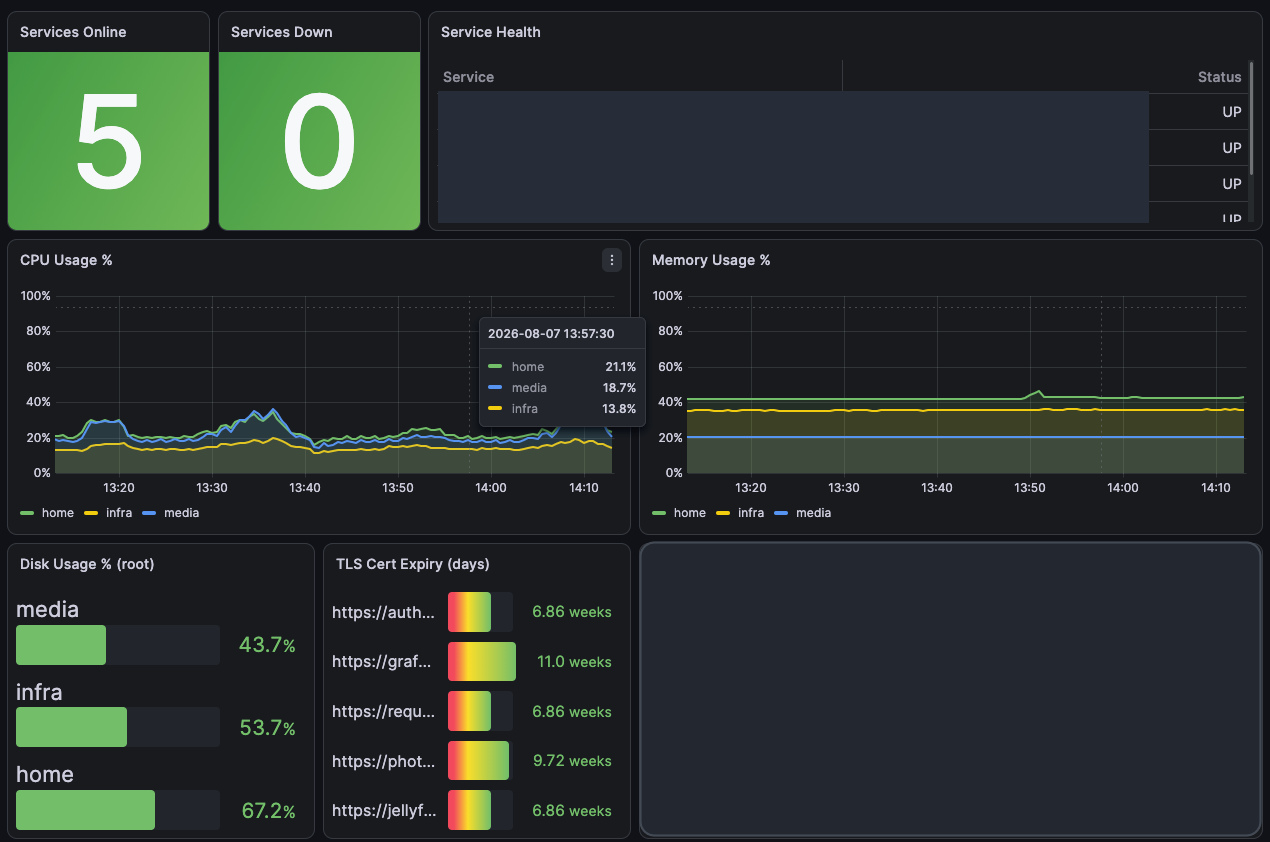
Een van de nuttigste beslissingen in deze setup is dat ik niet alles in één groot dashboard probeer te proppen. Ik gebruik vooral twee homelab-dashboards in Grafana, en die hebben bewust een ander doel.
Het eerste is een overzichtsdashboard. Dat helpt mij antwoorden op vragen zoals:
- zijn de meeste diensten online?
- welke host zit onder druk?
- zie ik opvallende foutpieken of logvolume?
- loopt een certificaat richting vervaldatum?
Dat is het dashboard waar ik snel oriëntatie uit haal. Meer cockpit dan werkbank.
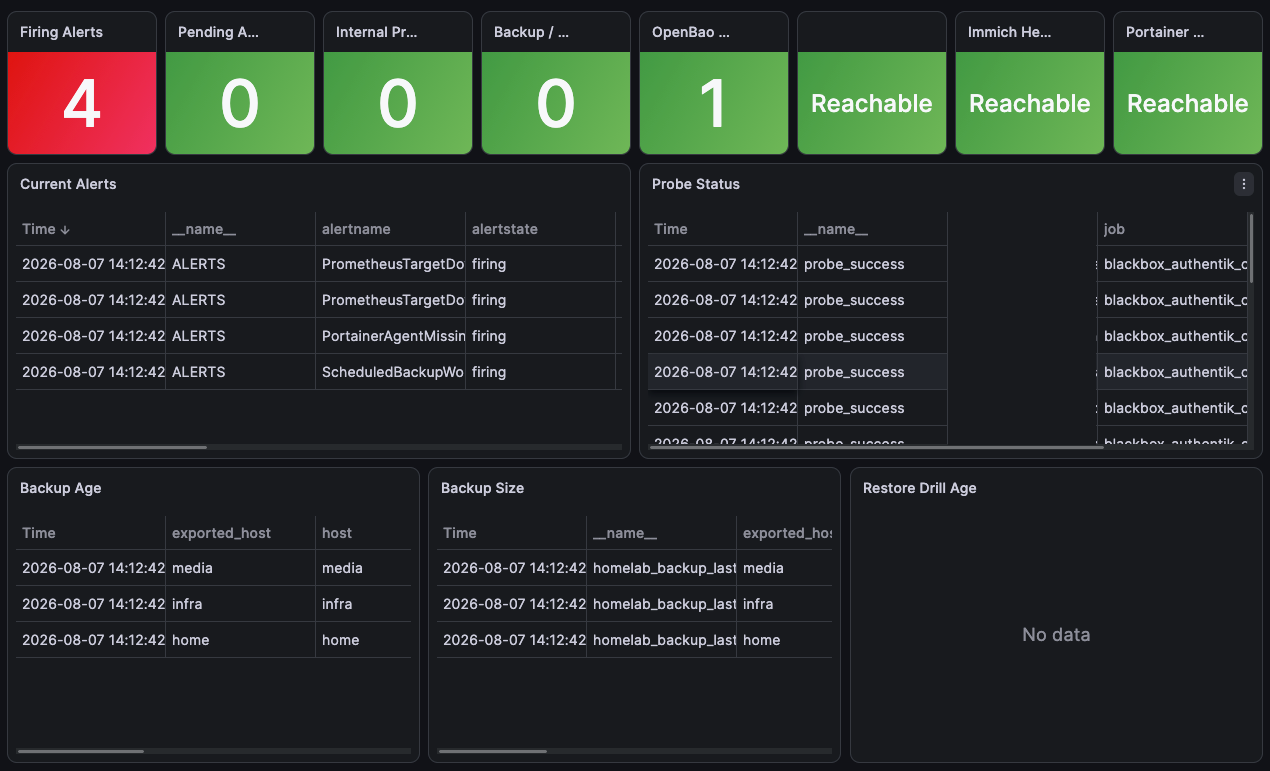
Het tweede is een operations-dashboard. Dat gebruik ik wanneer ik al weet dat ik dichter op de bal moet zitten. Daar kijk ik onder meer naar:
- firing en pending alerts
- interne probes die falen
- health van gevoelige delen zoals OpenBao, Portainer, Immich of qBittorrent
- backup- en drillgerelateerde signalen
Voor mij is dat verschil belangrijk. Een overzichtsdashboard moet rust geven. Een operations-dashboard mag juist wat directer zijn en sneller tonen waar de pijn zit.
Ik heb lang gemerkt dat één groot dashboard bijna altijd twee dingen tegelijk probeert te doen, en daardoor in geen van beide echt goed is.
Als je alles in één scherm stopt, wordt het ofwel te druk om overzicht te geven, ofwel te oppervlakkig om echt op te opereren. Door die twee uit elkaar te trekken, hoef ik minder te twijfelen over wat ik eigenlijk aan het bekijken ben.
Het overzichtsdashboard helpt mij vooral om te scannen. Het operations-dashboard helpt mij om door te pakken.
Dat klinkt als een klein verschil, maar in de praktijk scheelt het veel. Zeker in een homelab, waar je vaak maar een paar minuten hebt om iets snel te controleren.
Alerting is voor mij geen vervanging van dashboards
Naast Grafana draait er ook een Telegram-stroom via Alertmanager. Dat is voor mij geen tweede dashboard in chatvorm, maar gewoon de kortste weg tussen een afwijking en mijn aandacht.
Ik vind alerts pas nuttig als ze aan een paar voorwaarden voldoen:
- ze moeten zeldzaam genoeg blijven om serieus te nemen
- ze moeten duidelijk genoeg zijn om meteen richting te geven
- ze moeten verwijzen naar signalen die ik ook kan terugvinden in Grafana of logs
Daarom probeer ik alerting vrij nuchter te houden. Niet elke metric verdient een melding. Wat ik vooral wil weten, is wanneer een dienst echt down is, een probe systematisch faalt, een intern pad niet meer reageert of een belangrijk deel van de setup zijn gezondheid verliest.
Voor mij is Telegram daarin gewoon de snelste weg tussen een probleem en mijn aandacht. Ik hoef niet eerst een dashboard open te zetten om te merken dat er iets misloopt. Zodra er een melding binnenkomt, wil ik wel snel naar Grafana kunnen gaan om te zien wat er precies aan de hand is en hoe breed het probleem zit.
Ik kies er ook bewust voor om die berichten na ongeveer een week automatisch te laten opruimen. Als ik een alert na een week nog altijd niet bekeken heb, dan is die op dat moment meestal niet meer relevant, of is er intussen al lang een nieuwere melding geweest. Dan hoef ik die rommel ook niet zelf nog eens op te kuisen. Kleine gelukjes.
Probes zijn even belangrijk als hostmetrics
Wat ik onderweg ook geleerd heb, is dat alleen naar CPU, geheugen en containermetrics kijken niet genoeg is. Een service kan technisch draaien en toch voor een gebruiker stuk aanvoelen.
Daarom gebruik ik ook probes. Niet alleen op interne endpoints, maar ook op gerouteerde paden en op beschermde routes. Zo meet ik niet alleen of een container nog leeft, maar ook of het pad naar die service logisch intact is.
Dat verschil is belangrijk. Een applicatieproces kan gezond lijken, terwijl routing, authenticatie of een intern dependencyprobleem de echte ervaring toch breekt. Monitoring moet dus niet alleen zeggen “er draait iets”, maar ook “het werkt nog op de manier waarop ik het bedoel”.
Dat is voor mij uiteindelijk de kern van deze setup. Ik wil niet gewoon meten omdat het kan. Ik wil snel zien wat aandacht vraagt, voldoende context hebben om gericht te kijken, en daarna vlot kunnen inschatten of iets echt stuk is of alleen even ruis maakt.
Voor deze reeks voelt dat voor mij ook als een logisch eindpunt. Eerst de vorm van het systeem, dan secrets en deployflow, en daarna de vraag hoe je het operationeel gezond houdt.
Verder lezen
9 september 2026
Secrets en deployflow in mijn homelab: wel reproduceerbaar, niet roekeloos
Git als bron van waarheid klinkt mooi, tot je moet beslissen waar wachtwoorden, tokens en runtime configuratie dan wel thuishoren. In mijn homelab zit de rust net in die scheiding: Git voor structuur en versies, een aparte secret store voor gevoelige inhoud, en een deployflow die die twee opnieuw samenbrengt.
26 augustus 2026
Mijn GitOps homelab, zonder mijn hele thuisnetwerk op straat te leggen
Een homelab documenteren is nuttig, maar ook delicaat. Ik wil tonen hoe mijn setup werkt, waarom ik voor GitOps koos en welke patronen bruikbaar zijn voor anderen, zonder tegelijk mijn volledige thuisnetwerk prijs te geven.